

PR #4797 — cpu_engine: accelerate image downscaling with NEON은 이미지 축소 중 반복되는 계산을 SIMD 를 통해 줄인 사례입니다.
1. Image: DownScale
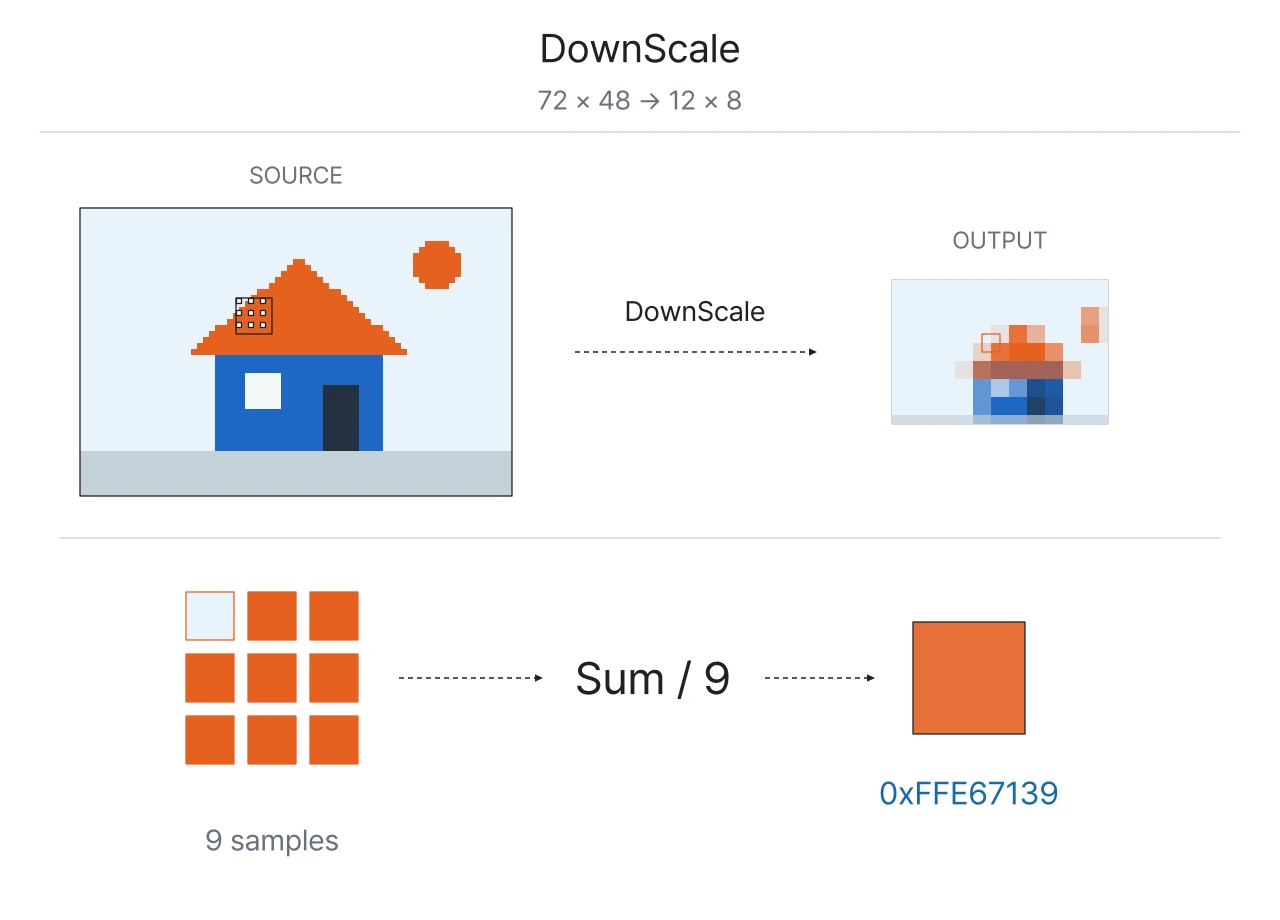
샘플링 영역에서 일정 간격으로 픽셀을 읽습니다. 픽셀의 채널 A·C1·C2·C3을 총합해서 평균을 내는 간단한 방식입니다.
- 영역: 중심 주변
2n × 2n,- 경계에서는 잘라서 사용
- 간격:
floor(n / 2) + 1;n = 3: 6×6 영역에서 9개 샘플 선택
코드 보기: 01. API · 호출 흐름 · scalar 누적
API 예제
auto image = Picture::gen();
image->load("sample.png");
image->scale(1.0f / 6.0f);
image->filter(FilterMethod::Bilinear);
canvas->add(image);
canvas->update();
canvas->draw(true);
canvas->sync();
호출 흐름
canvas->draw(true)
-> SwRenderer::renderImage()
-> rasterScaledImage()
-> _rasterScaledImageDispatch<false>()
-> _rasterScaledImage()
-> _scaleMethod()
-> _interpDownScaler()
-> cInterpDownScaler() / neonInterpDownScaler()_scaleMethod()는 Bilinear이고 image.scale < 0.5인 경우 DownScale 경로를 선택합니다. 이 예제의 scale은 1/6, 내부 sample size는 n = 3입니다.
DownScale 함수 전체 — cInterpDownScaler()
static inline uint32_t cInterpDownScaler(const uint32_t* img, uint32_t stride, uint32_t w, TVG_UNUSED uint32_t h, float sx, TVG_UNUSED float sy, int32_t miny, int32_t maxy, int32_t n)
{
    size_t c[4] = {0, 0, 0, 0};

    auto minx = static_cast<int32_t>(sx) - n;
    if (minx < 0) minx = 0;

    auto maxx = static_cast<int32_t>(sx) + n;
    if (maxx >= static_cast<int32_t>(w)) maxx = w;

    auto inc = (n / 2) + 1;
    n = 0;

    auto src = img + minx + miny * stride;

    for (auto y = miny; y < maxy; y += inc) {
        auto p = src;
        for (auto x = minx; x < maxx; x += inc, p += inc) {
            c[0] += A(*p);
            c[1] += C1(*p);
            c[2] += C2(*p);
            c[3] += C3(*p);
            ++n;
        }
        src += (stride * inc);
    }

    c[0] /= n;
    c[1] /= n;
    c[2] /= n;
    c[3] /= n;

    return (c[0] << 24) | (c[1] << 16) | (c[2] << 8) | c[3];
}
반복이 끝나면 c[0..3]을 count로 나눕니다. C1·C2·C3는 packed pixel의 채널 위치를 뜻합니다. 영상은 0xAA_RR_GG_BB 입력을 사용합니다.
2. SIMD: Down Scale
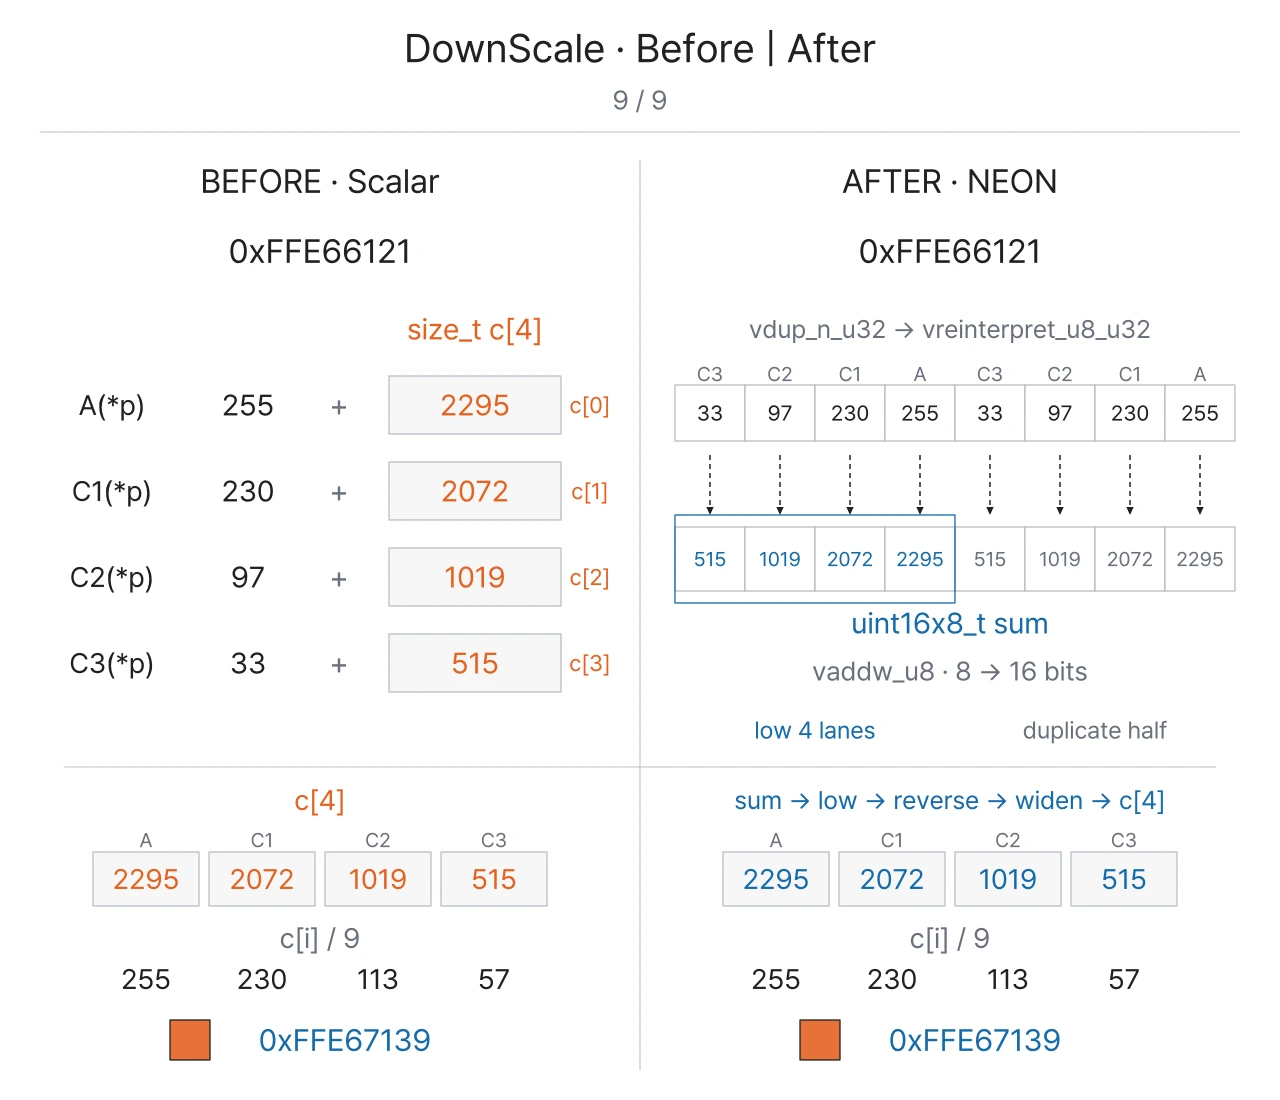
9개 샘플을 읽는 예제입니다. NEON의 vaddw_u8은 byte들을 16-bit로 넓히면서 각 lane의 합을 함께 갱신하므로, 샘플마다 채널을 따로 추출하고 더하는 작업을 줄입니다.
- 복제·재해석: 픽셀 하나 → 같은 픽셀 두 개 →
[C3 C2 C1 A]두 묶음 - 병렬 누적: 8개 lane이 함께 갱신되며, 복제된 양쪽 절반의 합은 동일
- 결과 복원: 아래쪽 4개 lane →
A C1 C2 C3순서 → 32-bit 값 → 정수 평균
3. 결과
| Benchmark | main 대비 FPS |
|---|---|
| Image — Default | +9.97% |
| Image — Rotation | −0.24% |
| MultiImage — Default | +3.78% |
| MultiImage — Rotation | −0.21% |